Академические опросы и опросы для аспирантов
Опрос для академических и постдипломных исследований создан специально для работы над магистерскими диссертациями и кандидатскими (PhD) диссертациями. Ваша анкета превращается в полноценную аналитическую среду: анализ надежности, описательные таблицы в стиле APA 7-го издания, факторный анализ, корреляция, регрессия и проверка гипотез — всё рассчитывается автоматически на основе собранных ответов, избавляя вас от ручного ввода данных в статистические программы.
Примечание: Примеры на этой странице взяты из выборочного исследования вовлеченности и успеваемости студентов университетов (300 респондентов). Данные сгенерированы для демонстрации и не являются реальными.
Что вы получаете
| Анализ | Что он вам показывает |
|---|---|
| Альфа Кронбаха для каждого конструкта и альфа при удалении пункта | Измеряют ли ваши пункты один и тот же показатель, и какой пункт ослабляет шкалу |
| Надежность внутри каждой группы | Применима ли шкала для мужчин и женщин, для каждого курса обучения и т. д. |
| Описательные таблицы APA 7th | Средние значения, стандартные отклонения, относительный вес и ранг — готово для вашей диссертации |
| Проверка на нормальность | Асимметрия, эксцесс, критерии Шапиро-Уилка и Колмогорова-Смирнова для выбора правильного теста |
| Разведочный факторный анализ | KMO, критерий Бартлета, собственные значения и факторные нагрузки после вращения |
| Корреляционная матрица | Пирсон или Спирман (выбирается на основе теста на нормальность) с поправкой Бонферрони |
| Множественная линейная регрессия | R², β, VIF, Дарбин-Уотсон и сопутствующие проверки |
| Различия между группами | t-критерий, Уэлч, ANOVA с апостериорными (post-hoc) сравнениями, Манн-Уитни и Крускал-Уоллис с размерами эффекта |
| Пре/пост-тестирование | Парный t-тест между двумя этапами опроса одних и тех же людей. См. Пре/пост-опросы |
| Экспорт для SPSS | Ваши данные вместе со справочником кодов (codebook) для любых самостоятельных расчетов |
Подготовка опроса к анализу
Для корректной работы анализа необходимы четыре настройки. Установите их до начала сбора ответов:
- Назначьте каждому пункту шкалы конструкт. В каждом вопросе с оценкой укажите Конструкт / Измерение исследования (например, «Поведенческая вовлеченность»). На его основе рассчитываются надежность и баллы по конструктам.
- Отметьте вопросы с отрицательной формулировкой как реверсивные. Например, «Я пропускаю лекции без уважительной причины» в шкале вовлеченности. Установите галочку Этот пункт является реверсивным, иначе он занизит альфа-коэффициент шкалы.
- Сопоставьте пол и возраст, а также выберите конструкты, формирующие общий балл, в разделе Настройки → Маппинг.
- Выберите дизайн исследования в разделе Настройки → Анализ и тесты (например, корреляционное или причинно-сравнительное исследование). Нужные тесты включатся автоматически.
См. разделы Создание опроса и Настройки опроса.
Открытие анализа
Откройте раздел Просмотр ответов и результатов и выберите вкладку Академический анализ и надежность (Кронбах). В верхней части доступны: Экспорт для SPSS (.csv Codebook) и Печать отчета.
Надежность: альфа Кронбаха
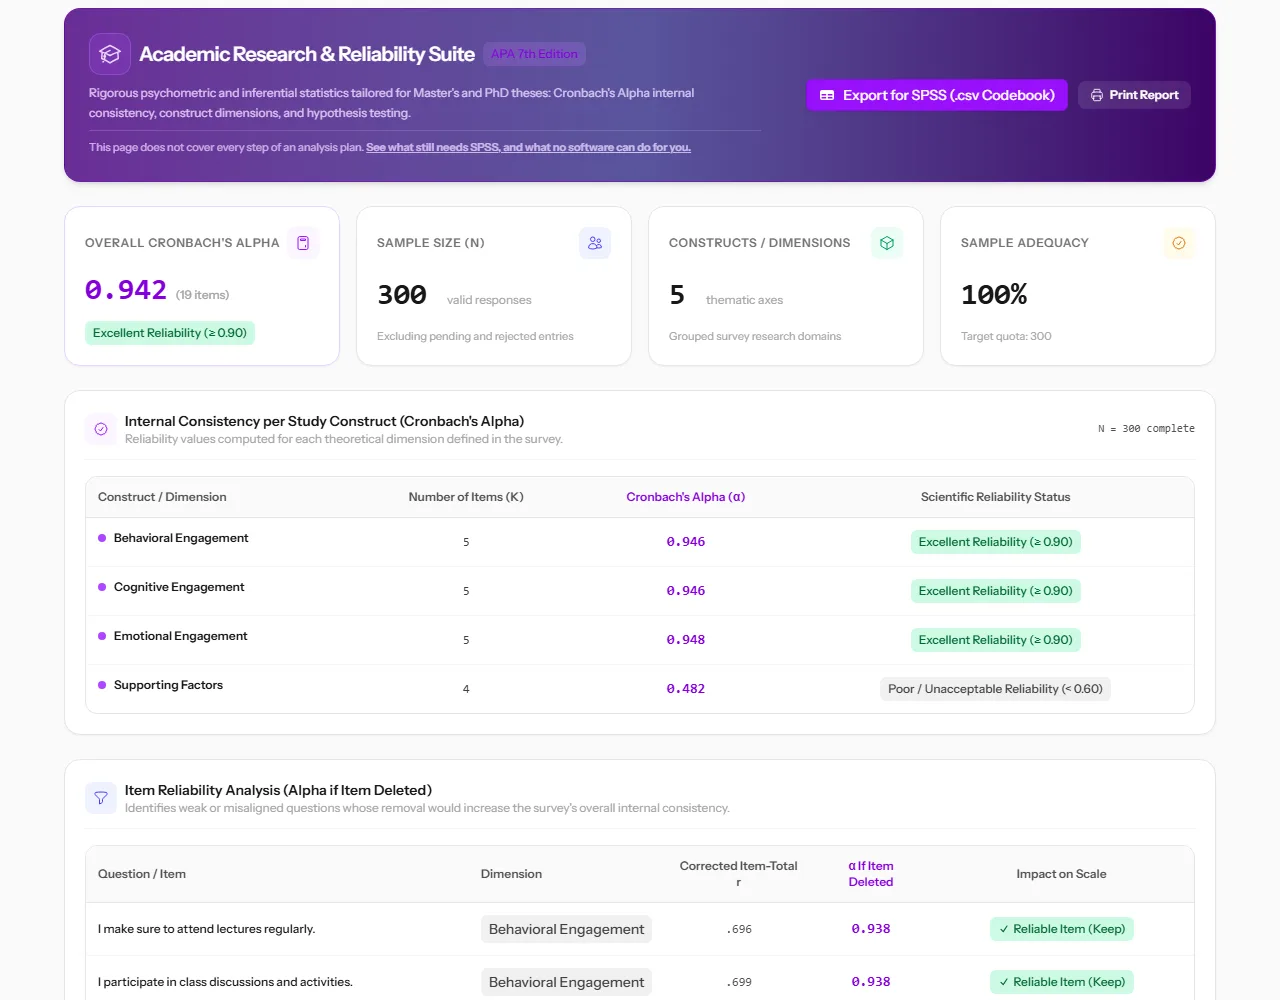 Три конструкта показывают отличную надежность (от 0.946 до 0.948). «Вспомогательные факторы» демонстрируют низкий результат — 0.482.
Для каждого конструкта рассчитывается коэффициент альфа и дается четкая оценка: от Отлично (0.90 и выше) до Плохо / Неприемлемо (ниже 0.60).
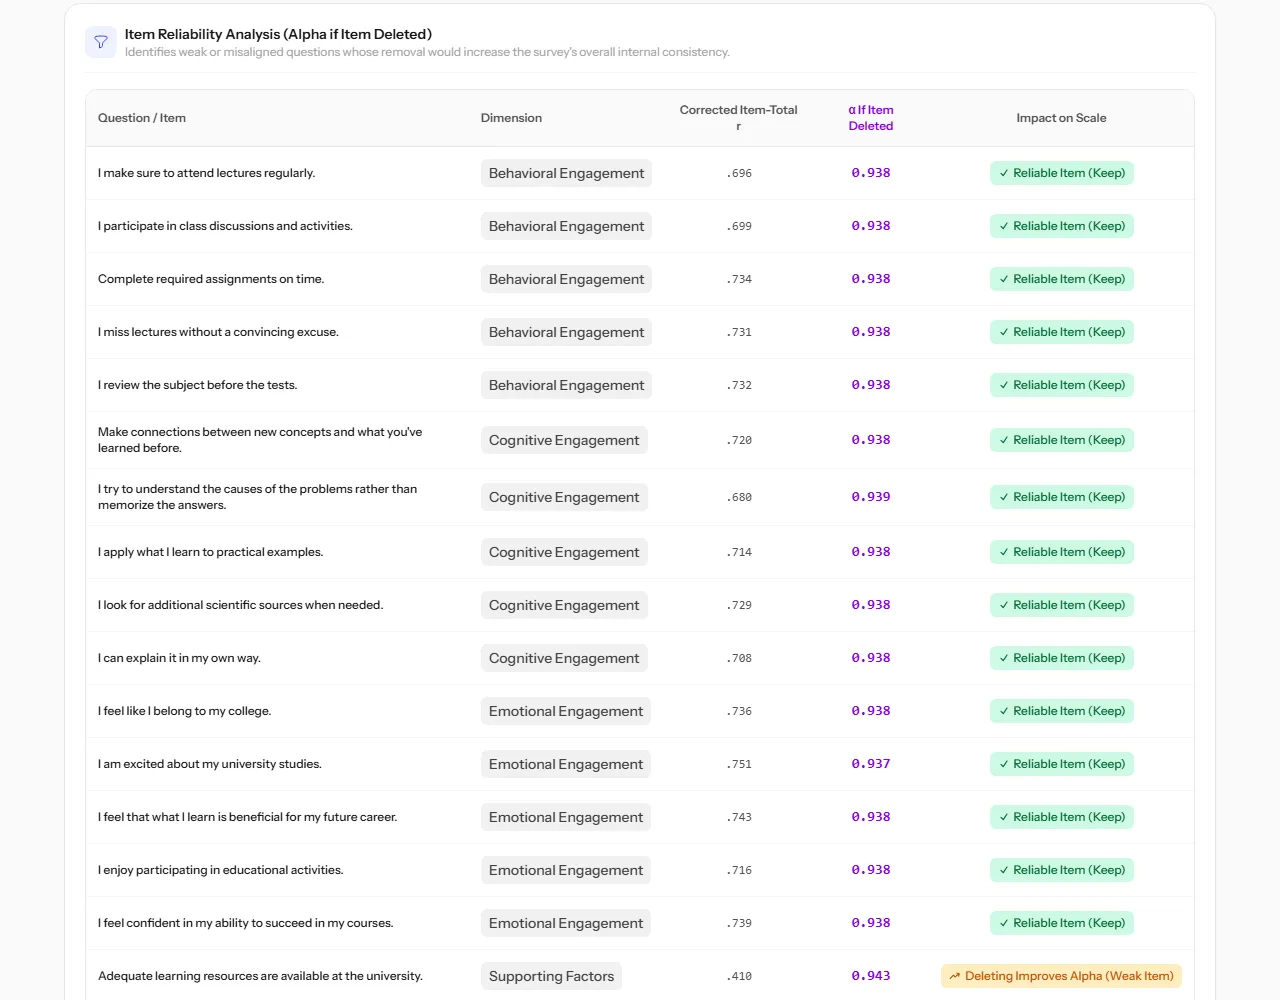
Ниже представлен Анализ надежности пунктов (альфа при удалении пункта), который показывает корреляцию каждого пункта с остальной частью шкалы, а также то, каким станет коэффициент альфа без этого пункта. Пункты, ослабляющие шкалу, отмечаются меткой Удаление повышает альфа (слабый пункт).
Описательная статистика в стиле APA
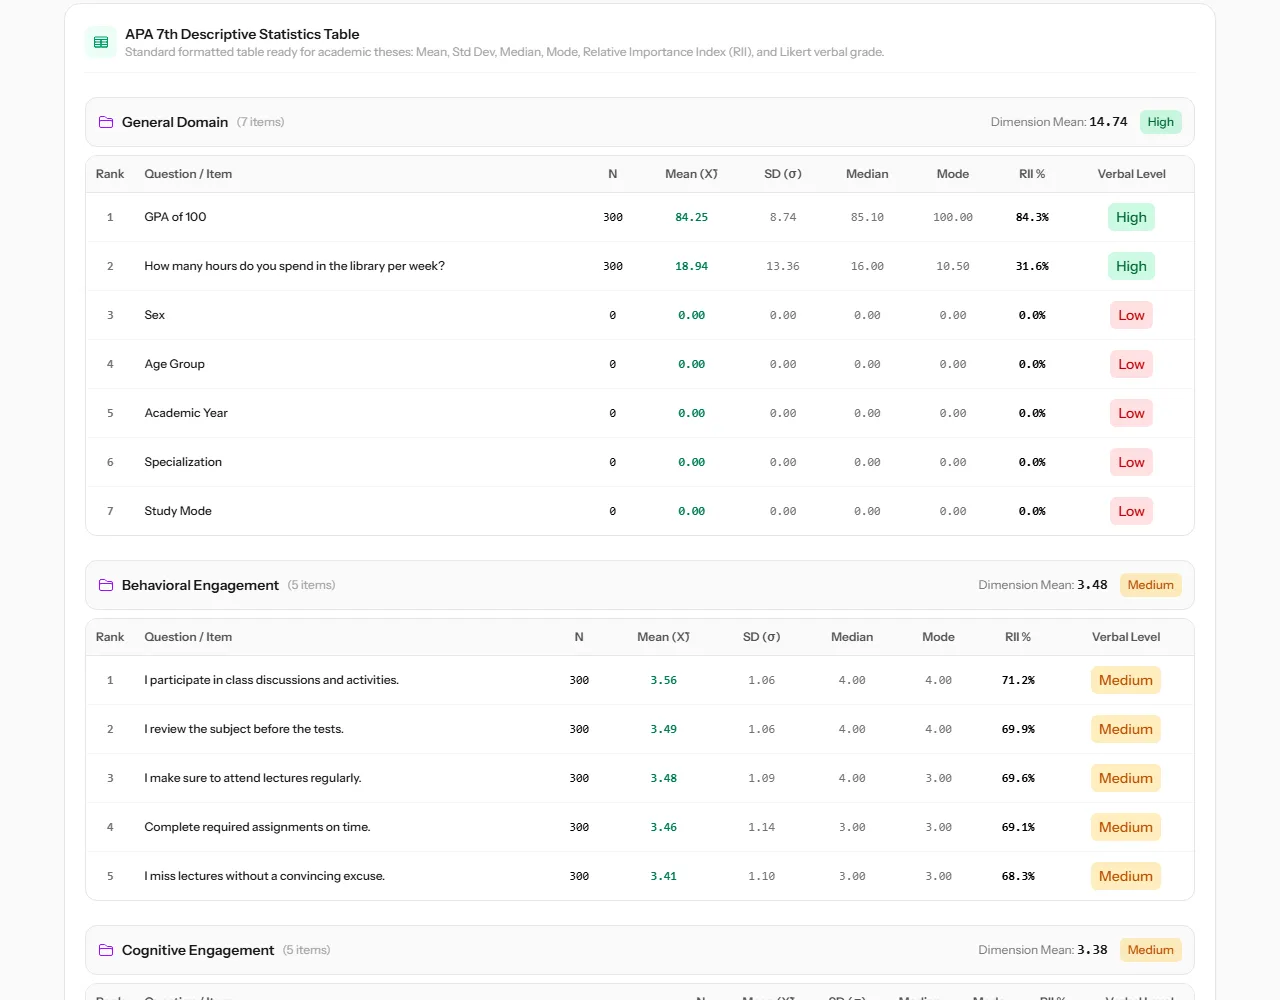 Среднее значение, стандартное отклонение, относительный вес и ранг для каждого пункта, сгруппированные по конструктам.
Таблица описательной статистики APA 7th содержит список всех конструктов и пунктов с указанием их среднего значения, стандартного отклонения, относительного веса и уровня (в виде ранжирования). Оформление полностью соответствует тому, как результаты представляются в главе диссертации.
Разведочный факторный анализ (EFA)
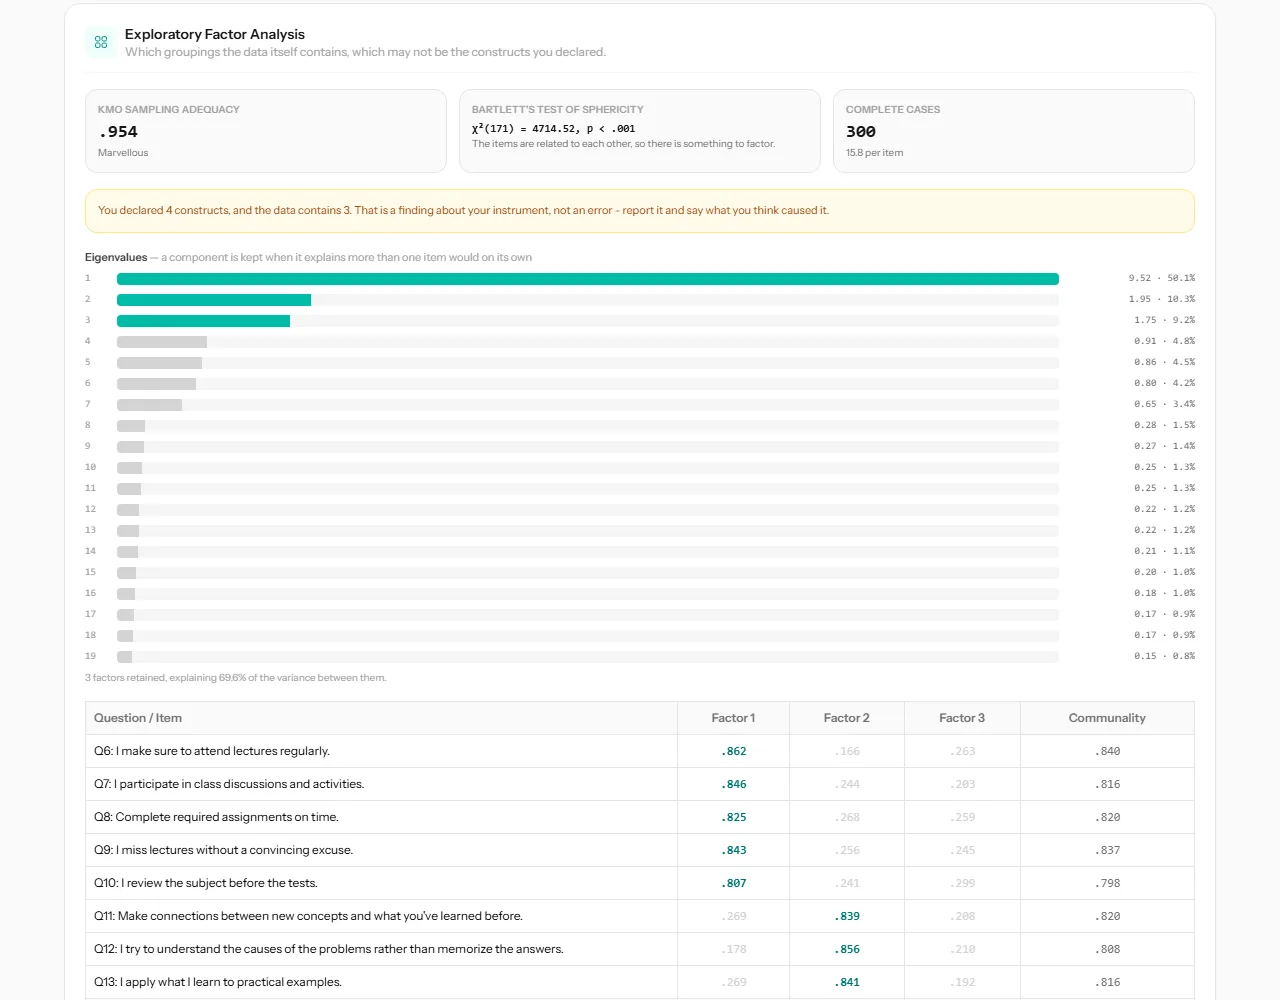 Сначала KMO и критерий Бартлета, затем собственные значения и нагрузки после вращения.
Перед выделением факторов Pulseform проверяет пригодность ваших данных (KMO и критерий Бартлета). Затем отображаются собственные значения (eigenvalues), количество факторов для сохранения и варимакс-повернутые нагрузки (varimax-rotated loadings) каждого пункта. Именно так вы можете доказать, что ваши пункты объединяются именно в те конструкты, которые вы заложили при проектировании.
Корреляция
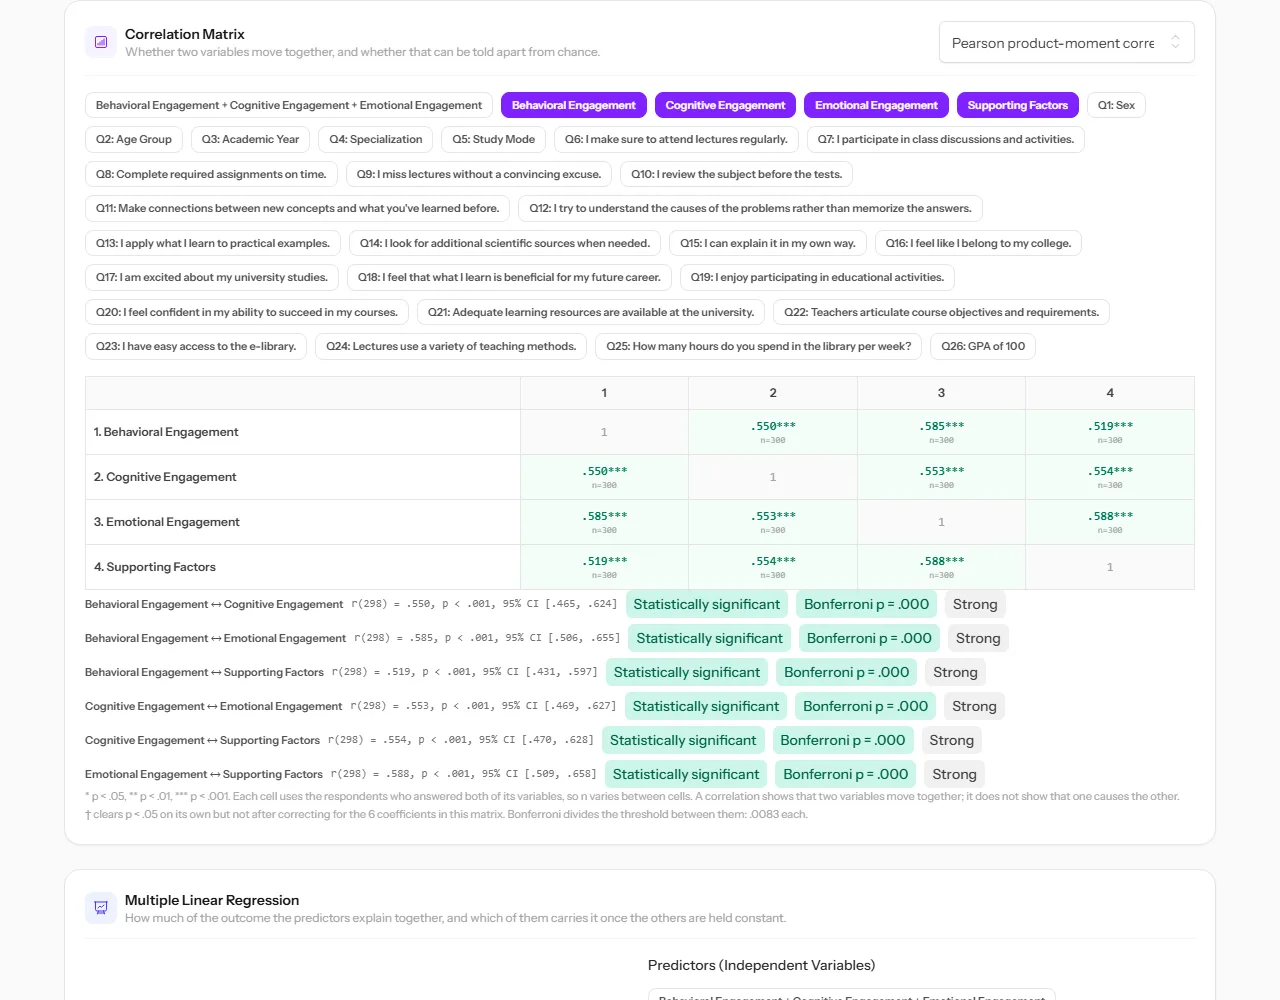
Выберите переменные, конструкты, общий балл или отдельные пункты и получите матрицу. Pulseform сначала проверяет данные на нормальность и рекомендует критерий Пирсона или Спирмена. Затем программа применяет поправку Бонферрони для всей матрицы и описывает силу каждой корреляции.
Множественная регрессия
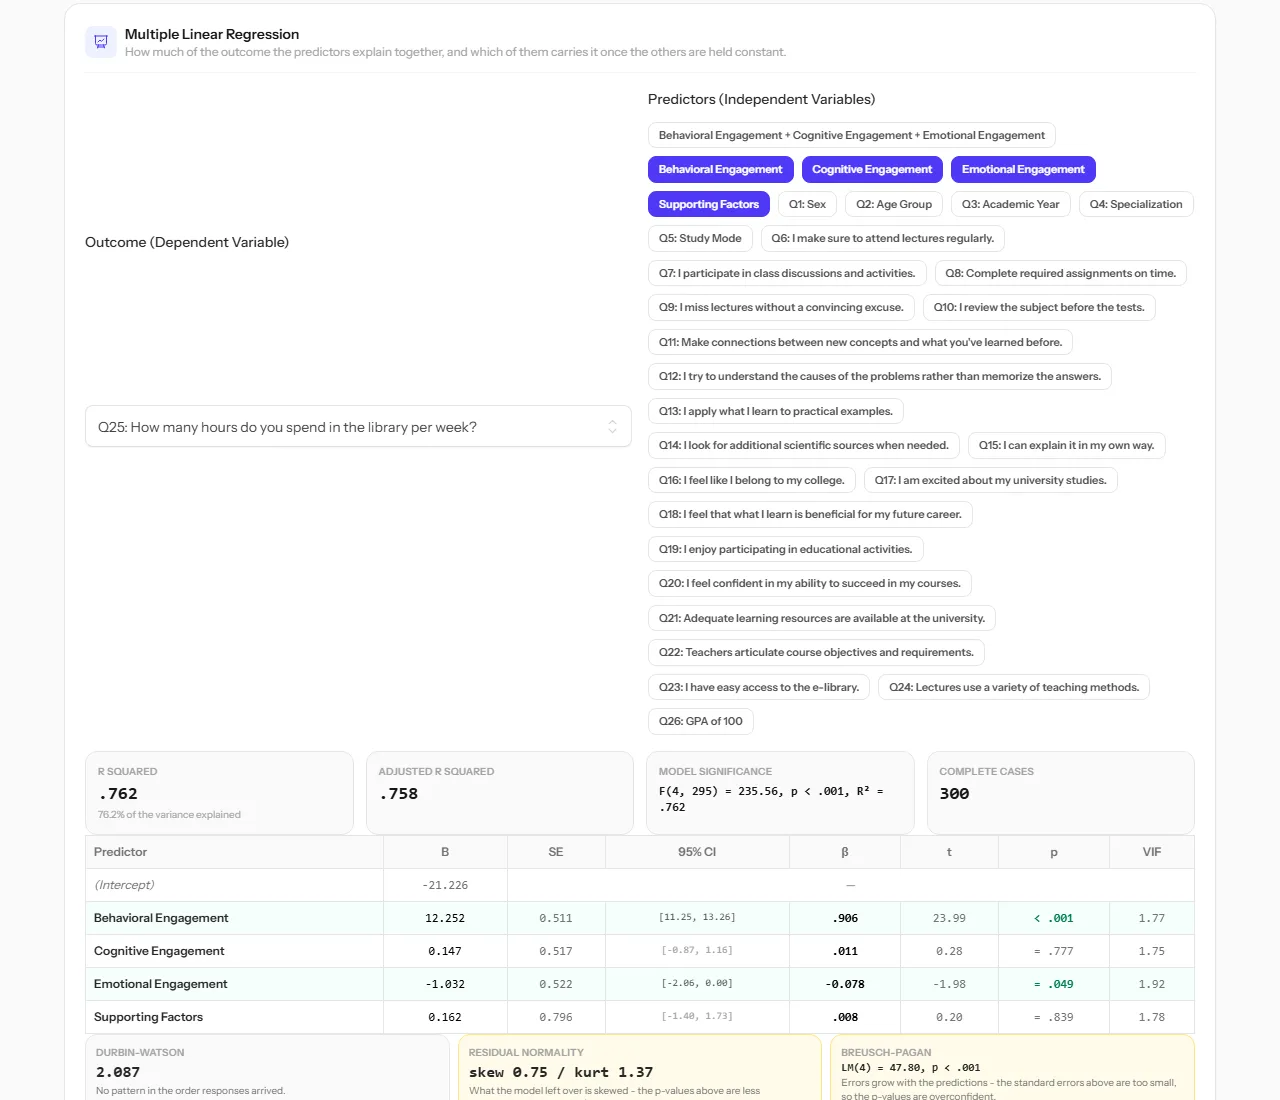 R² и β для каждого предиктора с проверками, которые обязательно запросит рецензент.
Выберите зависимую переменную (outcome) и ее предикторов. Вы получите R², скорректированный R², значимость модели, а также значения B, β, 95% доверительный интервал, p и VIF для каждого предиктора.
Под таблицей Pulseform выполняет проверку допущений: тест Дарбина-Уотсона, нормальность остатков и тест Бройша-Пагана. В данном примере программа предупреждает, что ошибки возрастают вместе с предсказаниями, поэтому значения p могут быть излишне оптимистичными. Именно такие проблемы легко упустить из виду при ручном расчете.
Различия между группами
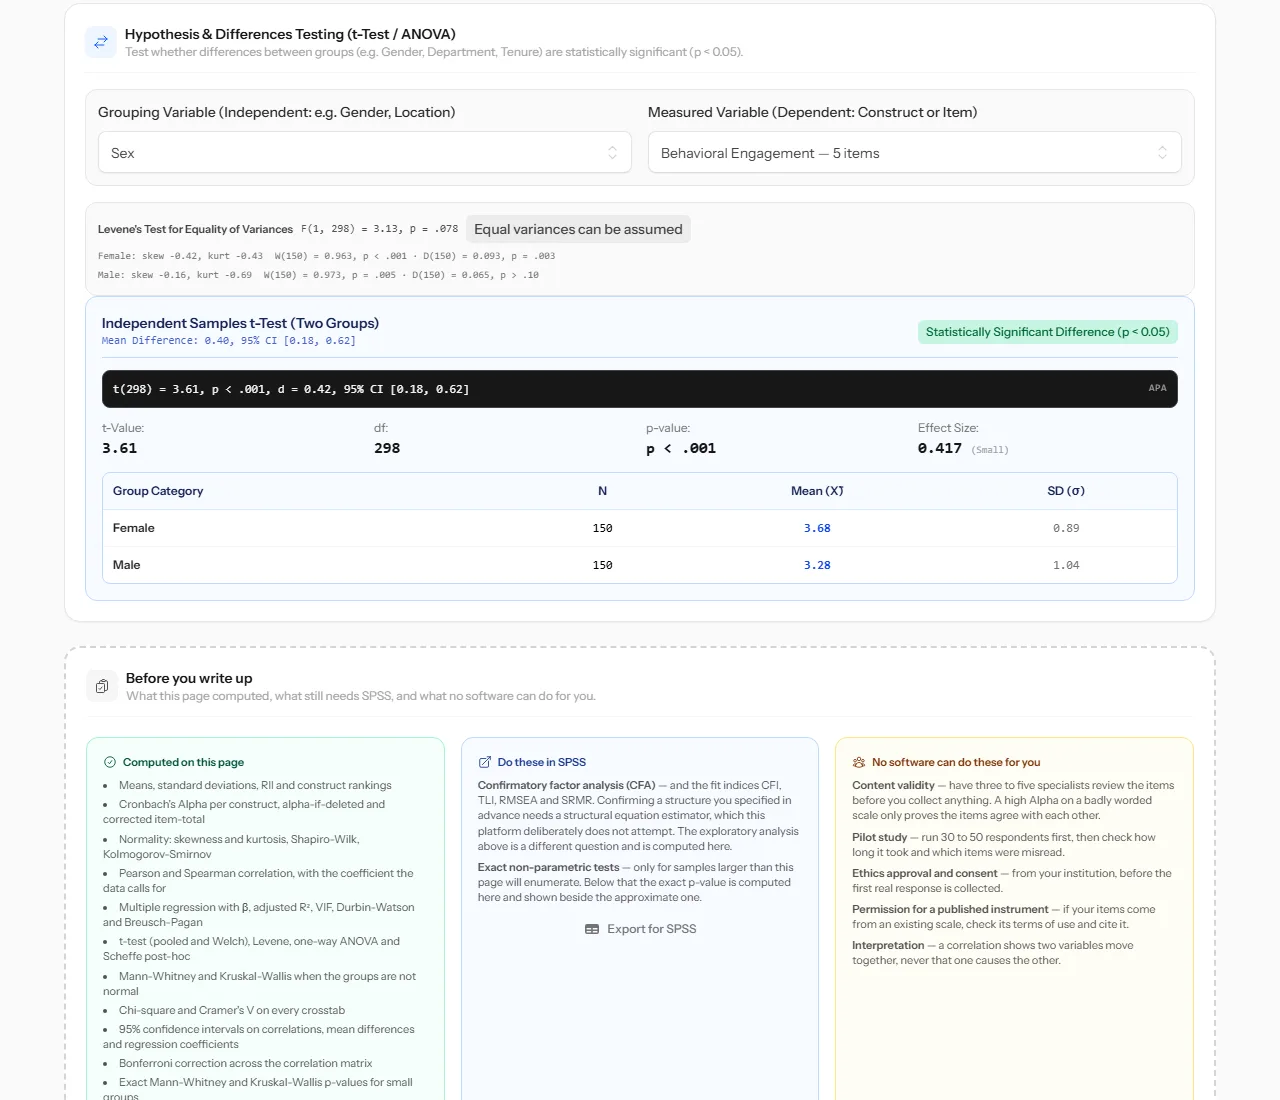 Поведенческая вовлеченность по полу: t(298) = 3.61, p < .001, d = 0.42.
Выберите группирующую переменную (например, пол или курс обучения) и измеряемую переменную (например, конструкт). Pulseform:
- проверяет равенство дисперсий с помощью критерия Левена и при необходимости использует тест Уэлча;
- использует t-критерий для двух групп и ANOVA для большего их числа с апостериорными (post-hoc) сравнениями, чтобы показать, какие именно группы различаются;
- переключается на критерий Манна-Уитни или Крускал-Уоллиса, если данные не подчиняются нормальному распределению, и вычисляет точные p-значения для малых групп;
- рассчитывает размер эффекта, чтобы вы понимали, является ли статистически значимое различие также практически значимым;
- формирует результат в виде готовой строки в формате APA, которую можно скопировать в диссертацию.
Перед оформлением текста работы
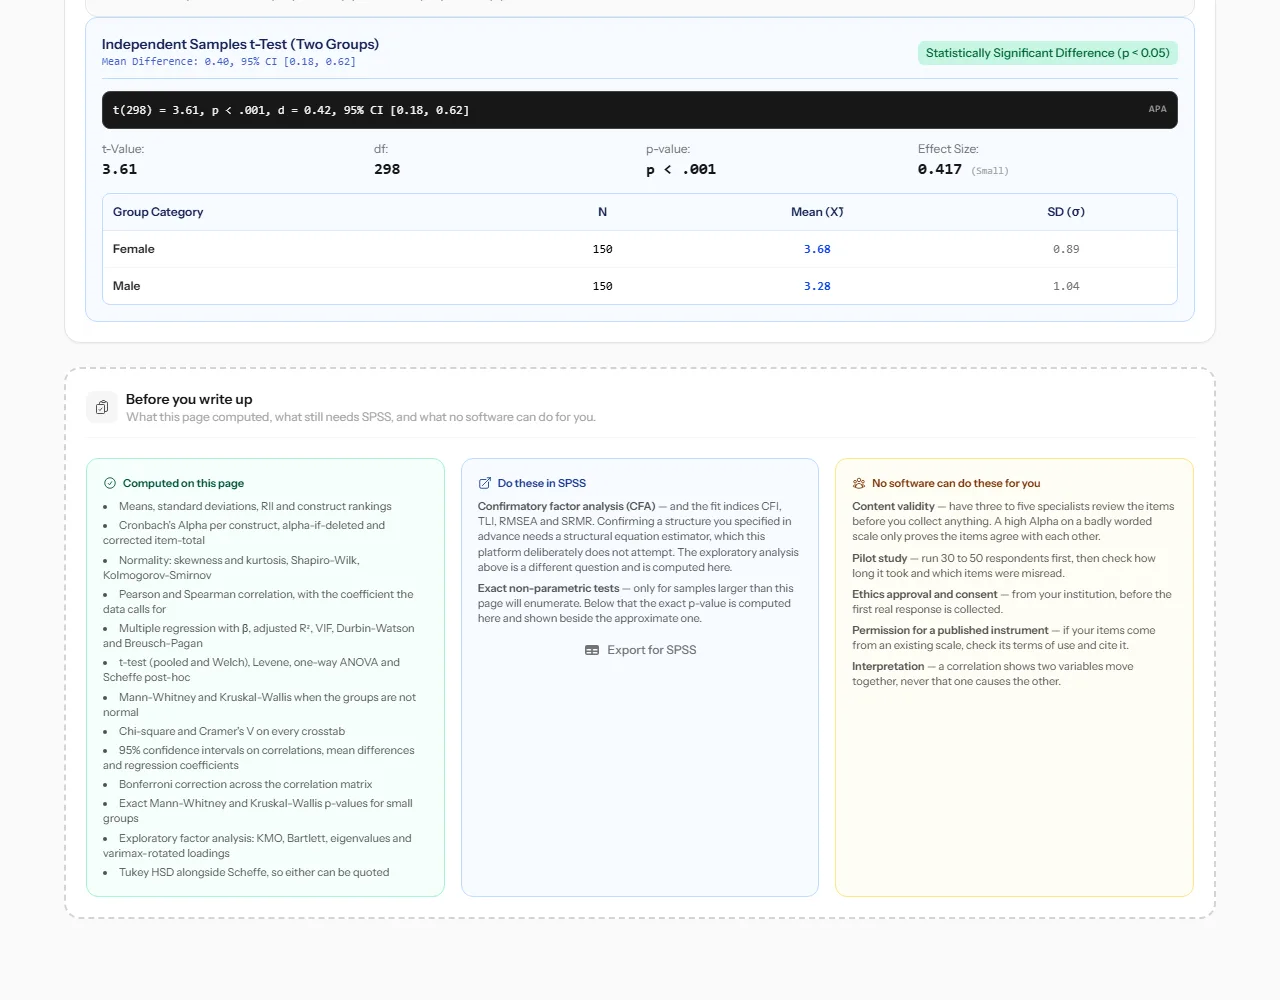
В самом низу страницы раздел Перед оформлением текста работы честно подсказывает:
- Рассчитано на этой странице: всё, что перечислено выше.
- Сделайте это в SPSS: например, конфирматорный факторный анализ (CFA), который Pulseform намеренно не выполняет. Используйте функцию Экспорт для SPSS.
- Никакая программа не сделает это за вас: проверка валидности содержания экспертами, пилотное исследование, одобрение этического комитета, разрешение на использование опубликованной шкалы и интерпретация результатов.
Когда Pulseform отказывается выводить цифру
Статистический показатель полезен только тогда, когда его поддерживают данные. Если это не так, Pulseform объясняет причину вместо вывода вводящих в заблуждение цифр.
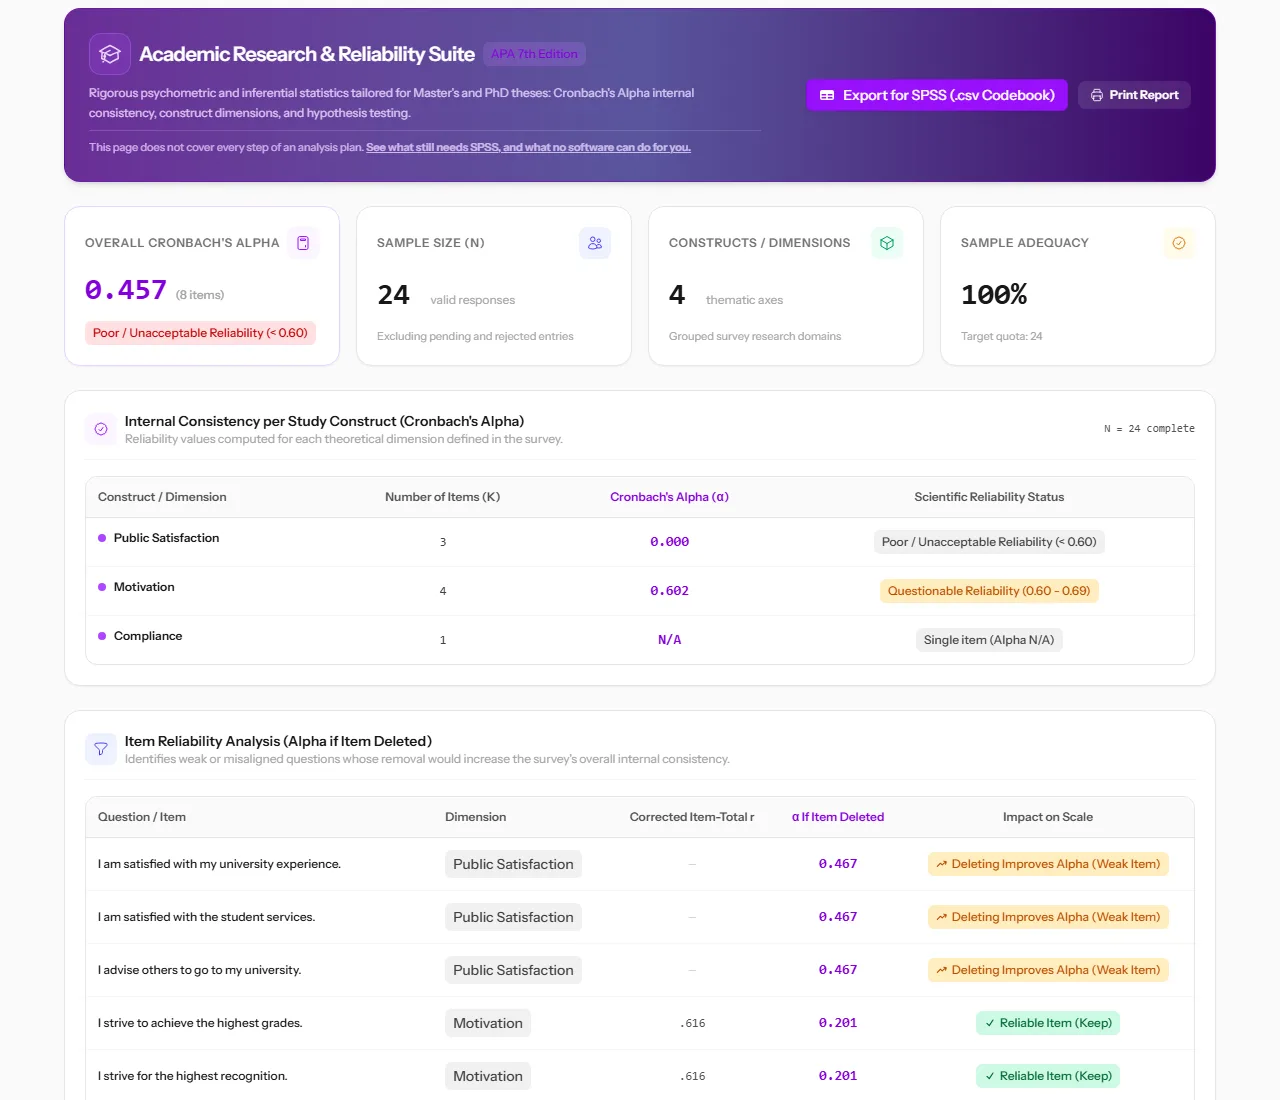 Специально созданное проблемное исследование: конструкт без вариации, шкала из одного пункта и отмеченные слабые пункты.
Примеры ситуаций, с которыми вы можете столкнуться:
- конструкт, на который все ответили одинаково, не имеет дисперсии для измерения;
- шкала, состоящая всего из одного пункта, не обладает внутренней согласованностью (альфа недоступна / N/A);
- группу из одного человека нельзя сравнивать;
- таблица сопряженности с малым количеством ответов в ячейках слишком разрежена для расчета критерия хи-квадрат.
Совет: Внимательно читайте эти сообщения. Обычно они указывают на проблему в анкете или выборке, которую стоит упомянуть в вашей диссертации.
Что делать дальше
- Измеряйте изменения с течением времени с помощью пре/пост-опросов.
- Ознакомьтесь с материалом Понимание результатов опроса — простым руководством по интерпретации самых распространенных показателей.